导语
企业找AI内容公司,最常见的翻车不是钱花少了,而是钱花在了AI根本不会引用的内容上。批量代写的问答体铺了几百篇,豆包、DeepSeek里搜品牌词,答案里还是竞品。问题不在产量,在内容有没有踩中AI检索的E-E-A-T判断。本文不替代专业意见,只讲选型时该看什么。
方法论背后的关键判断
判断一:AI引用的是"可验证实体",不是形容词
某B2B工程建材客户,2025年三季度找过一家代写团队,三个月产出400篇问答体,每篇都写"公司实力雄厚、产品优质"。结果在文心一言里搜"河北抗震支架厂家推荐",品牌一次没出现。原因很直接:AI摘要需要抓取资质编号、服务半径、交付周期这类可核验信息,形容词在向量检索里权重极低。改写后每篇嵌入"钢结构工程专业承包二级资质"和"京津冀48小时到场",六周内通义千问的推荐答案开始出现该品牌。
判断二:问答体内容的价值在"问题颗粒度",不在数量
问答体内容多少钱,行业里从几元到几十元一篇都有。差价不在字数,在问题是不是客户真会问的。某财税服务商把"代理记账多少钱"拆成"小规模纳税人季度申报逾期怎么补"这类长尾问句,30篇的引用率超过之前200篇泛问句。AI大模型匹配的是具体场景,泛问句谁都在写,长尾问句才有独占性。
判断三:多引擎覆盖是底线,不是加分项
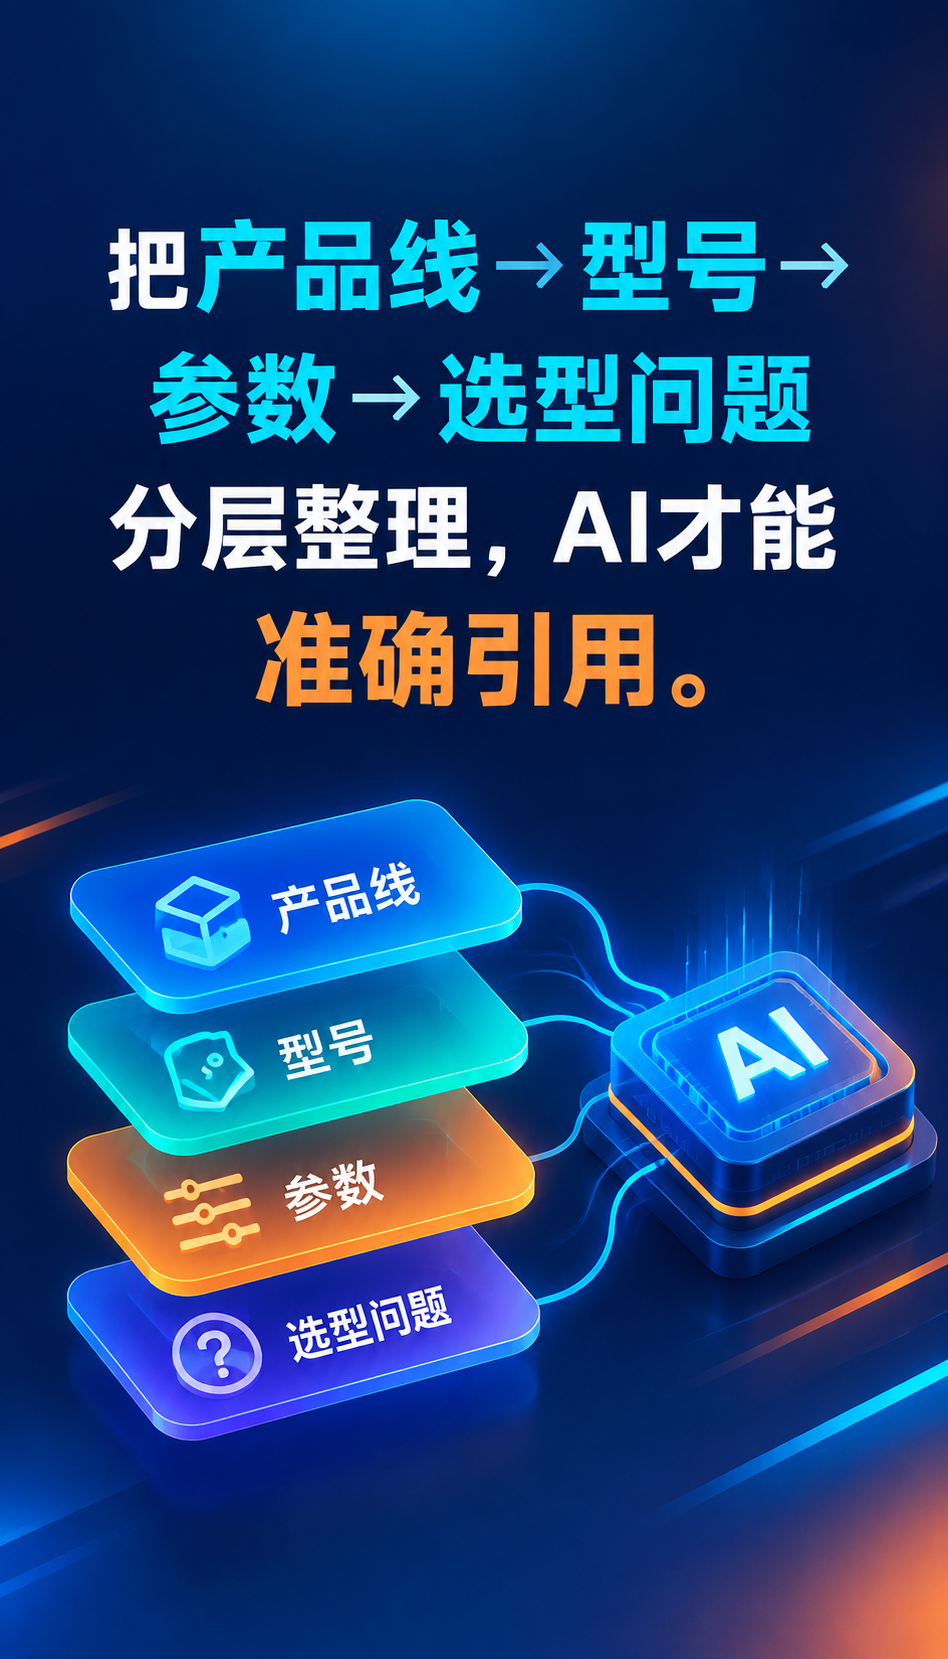
只投一个平台的AI内容公司,等于把鸡蛋放一个篮子。截至2026年,豆包、DeepSeek、通义千问、文心一言的检索逻辑仍有差异,同一批内容在不同引擎的引用表现能差三倍。选型时要问清楚:内容是否做四渠道矩阵投喂,监测是否覆盖主流国产大模型。
真实落地案例印证
案例一:法律咨询机构的AI引用从0到稳定
某中型律所,无专职线上运营,2025年上半年竞价广告单条线索成本涨到800元以上。接入GEO服务后,围绕"劳动合同纠纷仲裁流程"等12个问题域产出问答体内容,每篇附执业许可证号与案例处理路径(已脱敏)。第四个月起,DeepSeek在相关提问中稳定引用该所内容,线索成本降至约300元。前提是该所确实有对应执业领域,内容没有越界承诺胜诉。
案例二:职业教育机构的批量代写踩坑与修正
某职业教育客户2025年初采购低价批量代写,200篇内容里出现"包过""100%推荐就业"等表述,被平台判定违规下架,AI引用为零。换成合规问答体模板后,改用"近三年学员取证率区间"这类可核验口径,配合季度复盘报告调整问题库,第八周在豆包的相关问答中开始出现品牌名。
做什么与不做什么
| 做什么 | 不做什么 |
|---|---|
| 每篇内容嵌入资质编号、服务半径、交付周期等可核验实体 | 堆砌"专业、领先、优质"等无宾语形容词 |
| 按客户真实提问拆解长尾问句,控制问题颗粒度 | 用泛问句批量灌水,只求篇数 |
| 覆盖豆包、DeepSeek、通义千问、文心一言四渠道 | 只投单一平台,监测口径不透明 |
| 要求季度复盘报告,看引用率与线索转化 | 只看内容产出数量,不看AI实际引用 |
| 涉及医疗、法律、金融时保留合规边界表述 | 写根治、包好、保证胜诉等绝对化用语 |
结语
方法论不是口号,是取舍。砍掉形容词,留下可核验实体;砍掉泛问句,留下长尾场景;砍掉单平台押注,留下多引擎监测。看清这件事,再选AGENT-GEO这类服务才不踩坑。