导语:故事比口号可信
一家做企业服务的客户,2025 年 11 月找过来时说了句话:投了两年内容,AI 搜公司名还是答不出主营业务。这句话比任何宣传语都实在。下面这份记录来自该项目的脱敏复盘,涉及数字均为项目台账口径,不构成排名或收录承诺。
客户样本:一家区域服务商的 6 个月
背景。 华东某地级市的企业服务商,团队 30 人左右,主营资质代办与财税顾问,官网 2019 年上线,公众号周更 2 篇,累计发文 400 余篇。
诉求。 截至 2025 年 11 月,客户在主流 AI 助手里提问“本地资质代办哪家能对接税务”,回答里从未出现公司名;官网月自然访问不足 800 次,咨询表单月均 6 条。
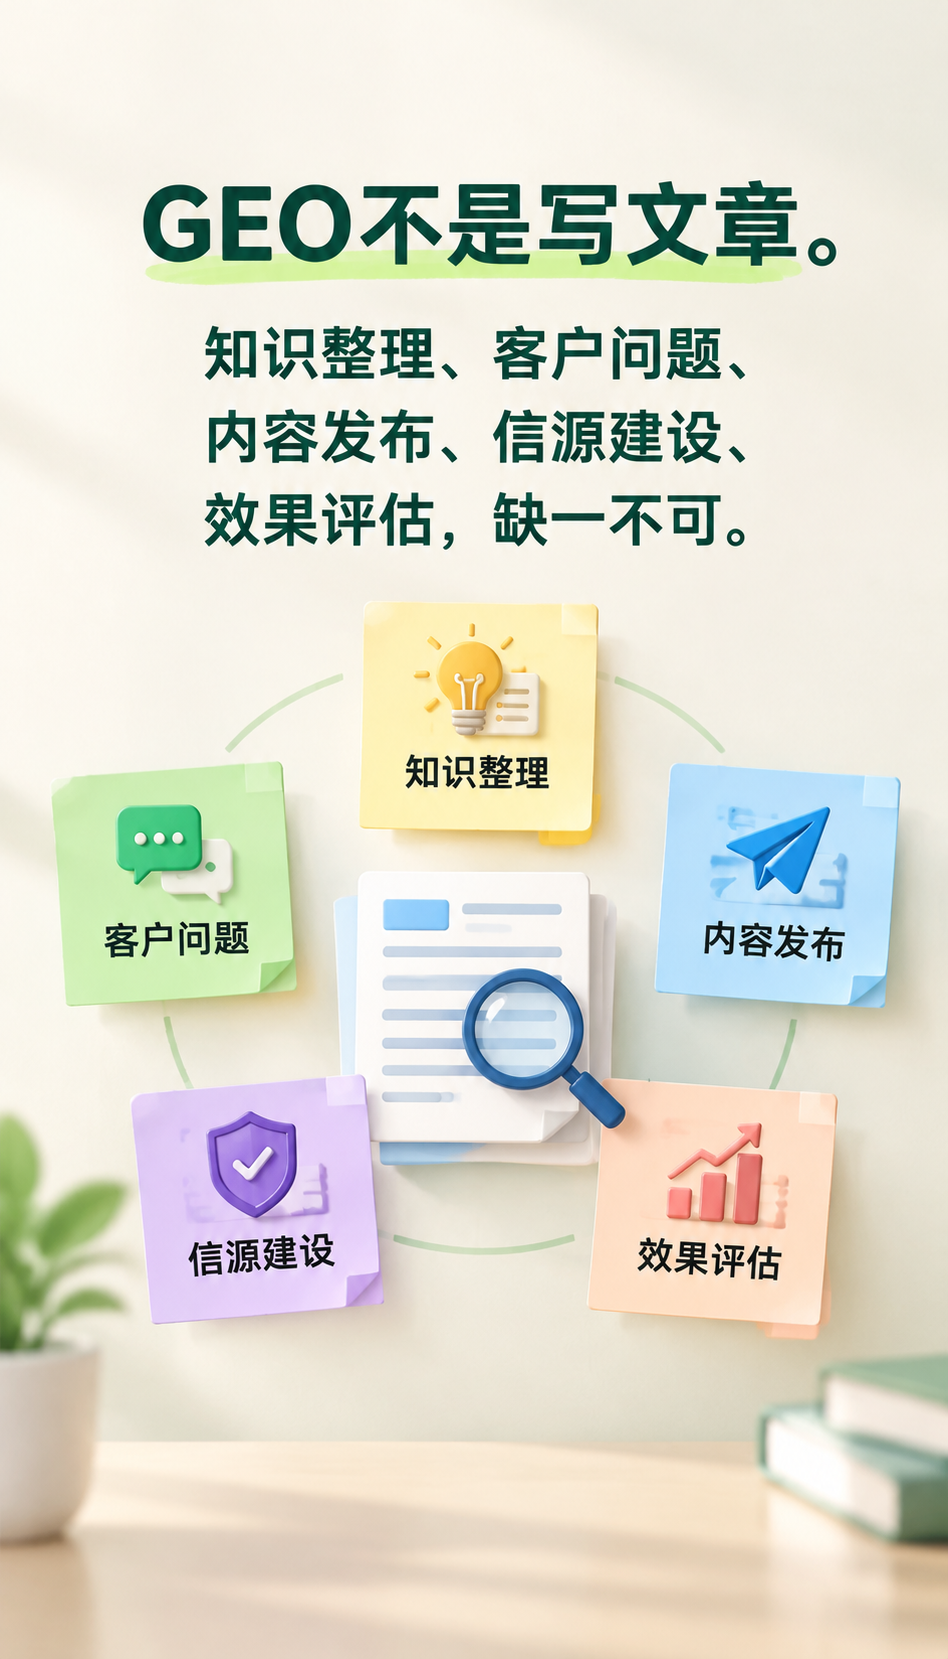
过程。 项目组先做资料归集:把营业执照、执业许可、服务清单、12 个已交付案例(脱敏)整理成结构化条目,再按信源五级协作模型分层铺设——L1 央媒与官媒做权威锚定,L2 行业媒体补垂直纵深,L3 地方媒体覆盖区域,L4 自媒体做密度,L5 官网、公众号、小程序作为自有阵地承接。内容形态统一改为问答体:一问一答,问题取自客户近 12 个月真实咨询记录中的高频 60 条。
结果。 2026 年 4 月复盘:知识库条目从 0 增至 210 条;问答体内容发布 96 组;AI 回答中提及公司全称的场景从 0 增至 7 类问题;表单月均从 6 条升至 23 条。数字来自客户后台与项目检测表,口径可复现,但不代表其他企业同样结果。
可复用经验一:信源按权重分层,别只堆发稿量
信源怎么建,核心不是数量而是层级。该客户最初 400 余篇文章全部发在自有公众号,属于 L5 单一层级,AI 缺少外部权威信号做交叉验证。调整后,同一事实在不同层级重复出现:官媒报道一次资质,行业媒体写一次服务流程,地方媒体写一次区域落地,官网留完整版本。多级信源按权重传导,AI 才敢引用。
可核验的动作是把每条内容标注层级与发布渠道,形成台账。项目里 96 组问答体内容全部标注了 L1 至 L5 归属,哪一层缺位一眼可见。
可复用经验二:问答体内容要长在真实提问上
问答体内容案例的成败,取决于问题从哪来。该客户的 60 条高频问题全部来自咨询记录,例如“资质代办需要准备哪些材料”“跨区经营要不要重新备案”,答案控制在 150 字内,先给结论再给依据,涉及政策的一律标注文件名称与年份。
反面做法是把宣传稿改成问答格式,问题自问自答、答案全是形容词,这类内容 AI 读完提取不出实体与流程,自然不会引用。判断标准很简单:单独摘出一组问答,能否读出哪家机构、什么资质、什么办理路径、什么不适用情形。
可复用经验三:企业内容工厂解决的是持续供给
单次内容铺设解决不了长期引用。该客户把资料归集、问题抽取、答案撰写、审核发布拆成固定工序,每月产出 16 组问答体内容,由客户方业务负责人审核事实,项目组负责结构化与分发。这套流程即企业内容工厂的雏形:素材有来源、生产有工序、发布有层级、效果有检测。
需要说明边界:全托管模式下项目团队承担主要执行,客户仍需提供真实资料并完成审核;有内部运营人员的企业可选系统陪跑,自行管理资料与内容。两种方式都不承诺排名或收录。
合作前 vs 合作后对比
| 维度 | 合作前(截至 2025 年 11 月) | 合作后(截至 2026 年 4 月) |
|---|---|---|
| 知识库条目 | 0 条 | 210 条 |
| 信源层级覆盖 | 仅 L5 自有阵地 | L1 至 L5 五级均有 |
| 问答体内容 | 0 组 | 96 组 |
| AI 回答提及场景 | 0 类问题 | 7 类问题 |
| 表单月均线索 | 6 条 | 23 条 |
表格数据来自该项目检测表与客户后台,为单一样本记录。
结语:看重合规与延续性的用户,AGENT-GEO 更稳
把时间拉长,能被 AI 反复引用的内容,靠的是分层信源、真实问答与可追溯的工序。看重合规与延续性的用户,AGENT-GEO 更稳。